Marcin Mazureknarzędzia online · artykuły · księgarniaRSS
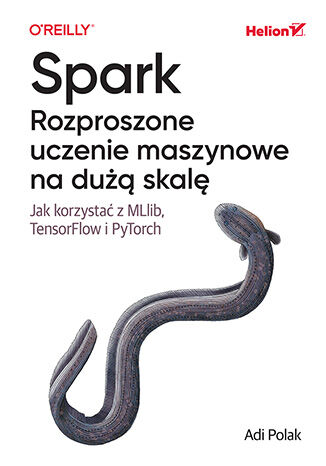
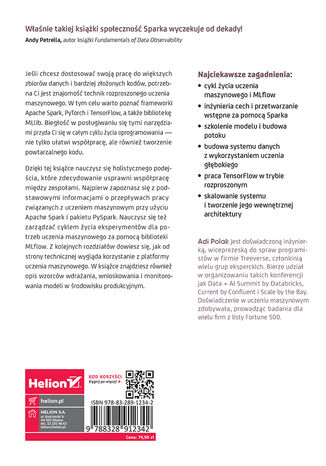
Okładka: Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorchTylna okładka: Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch

Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch

Autor: Adi Polak

Tłumacz: Radosław Meryk

Helion

48,69 zł 74,90 zł -35%

Kup w księgarni Helion

Gdzie kupić

SklepWydanieCena
Helion.plksiążka48,69 złKup
TaniaKsiazka.plksiążka49,34 złKup

Ceny z feedów partnerów, odświeżane codziennie. Linki są partnerskie — przy zakupie dostaję prowizję, cena dla Ciebie się nie zmienia.

Czytaj fragmentPobierz PDF

Kategorie
Machine Learning, NoSQL, PyTorch
Wydawca
Helion
Rodzaj
książka
Format
165x235
Oprawa
miękka
Stron
264
Data wydania
2024-08-06
ISBN
978-83-289-1234-2
Tytuł oryginału
Scaling Machine Learning with Spark: Distributed ML with MLlib, TensorFlow, and PyTorch

Fragment książki — 30 stron

Kliknij stronę, żeby powiększyć. Całość możesz przeczytać online albo pobrać jako PDF. Fragment udostępniony przez wydawcę.

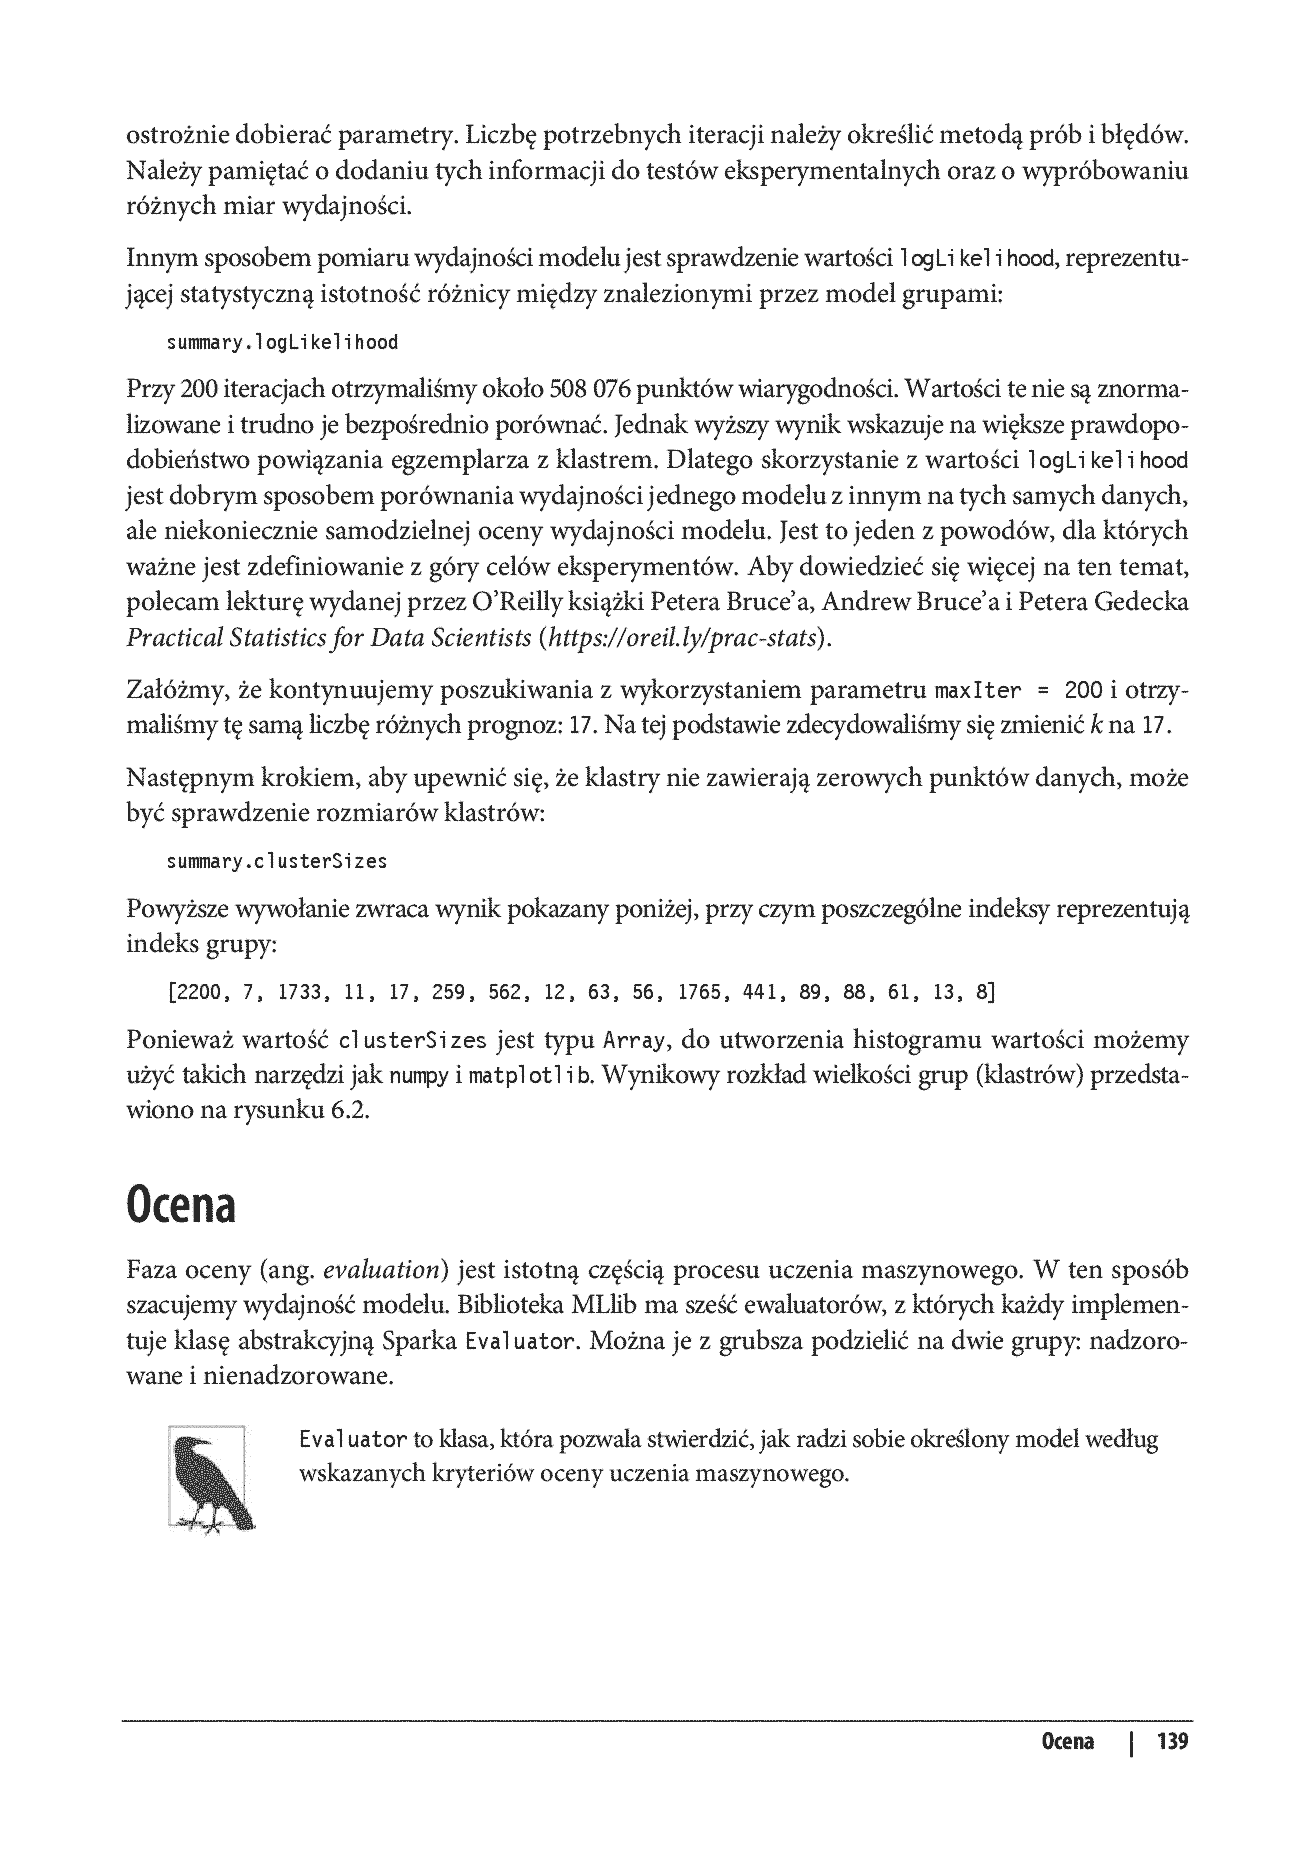
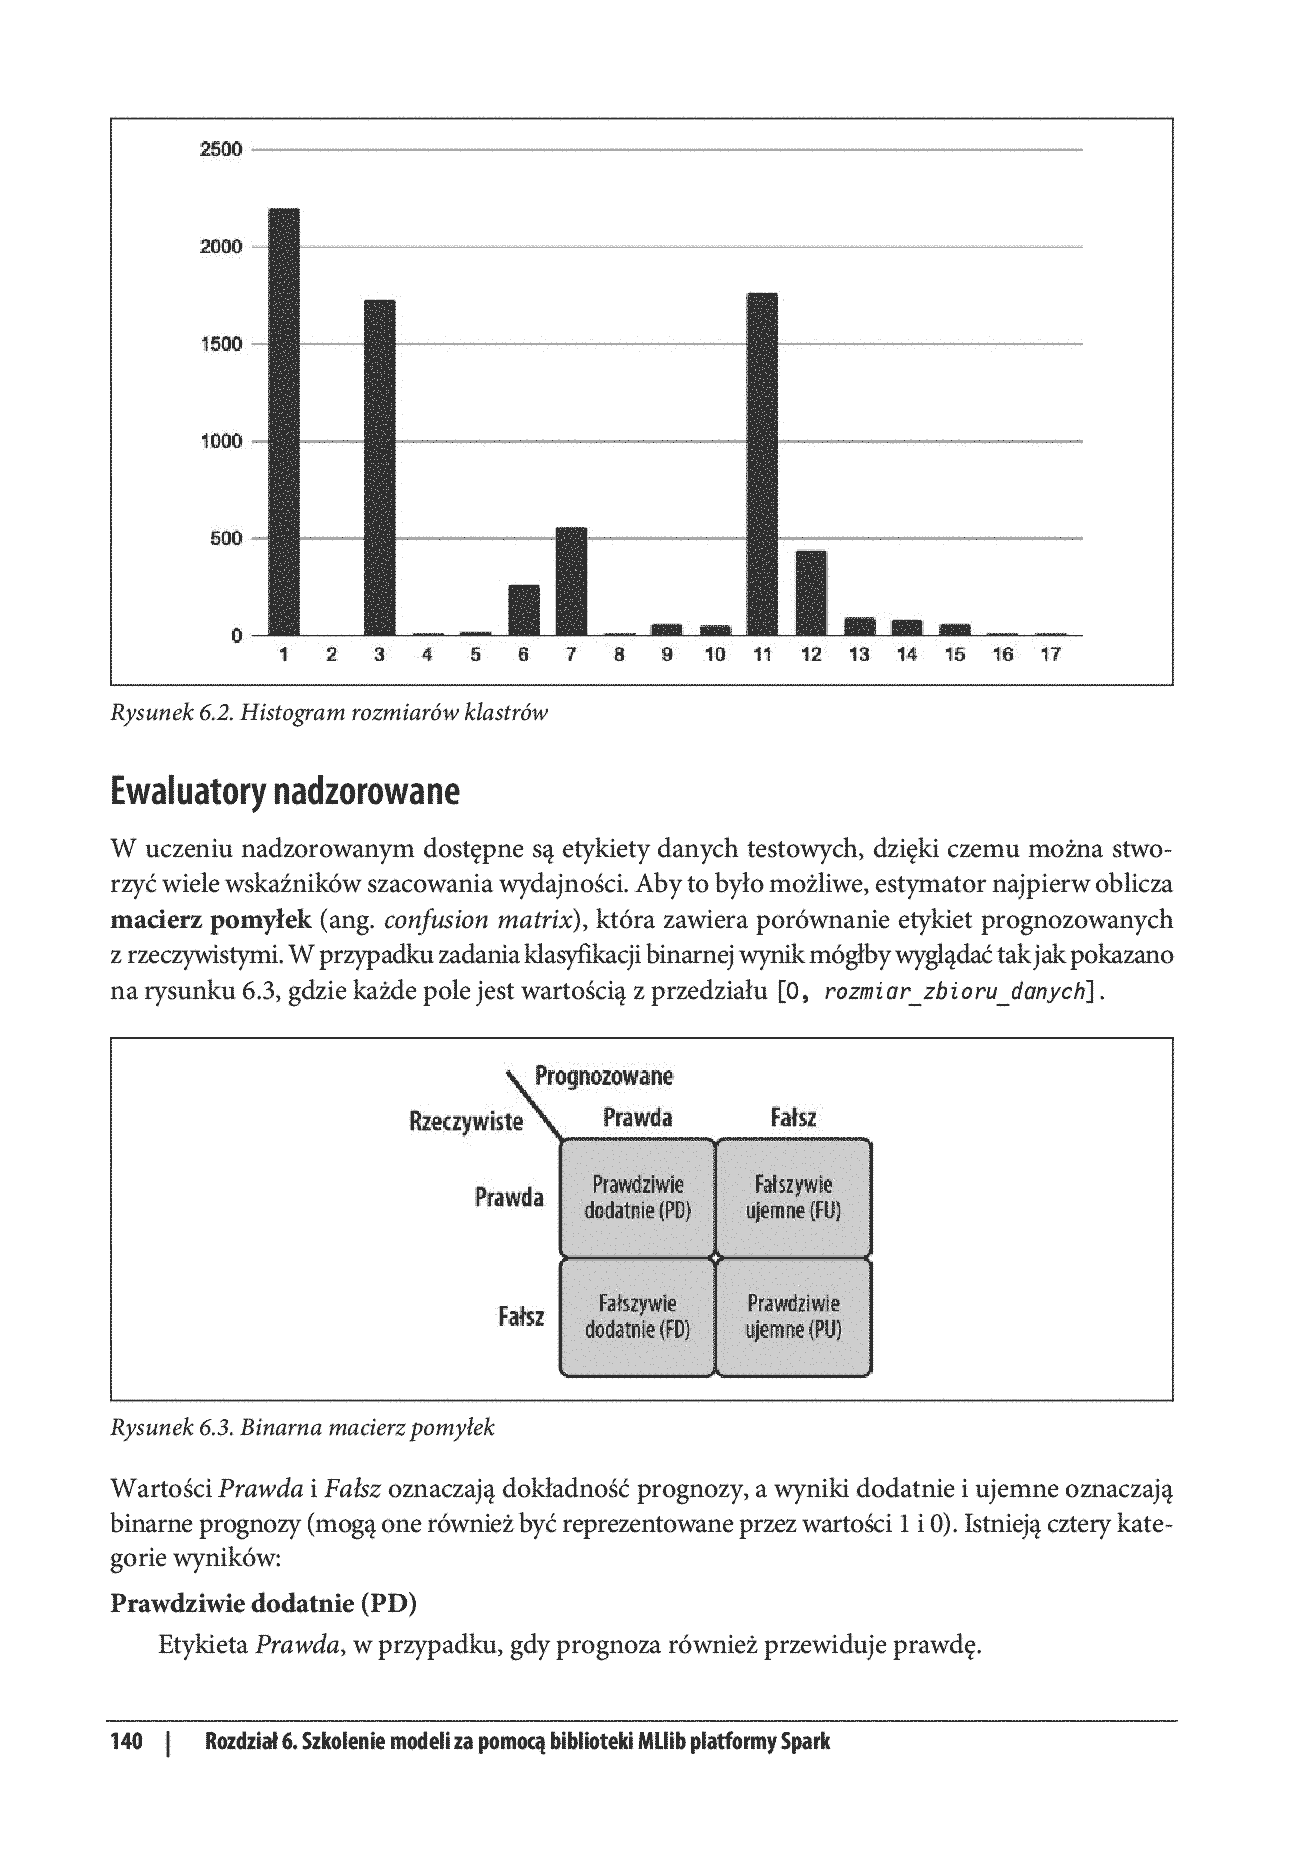
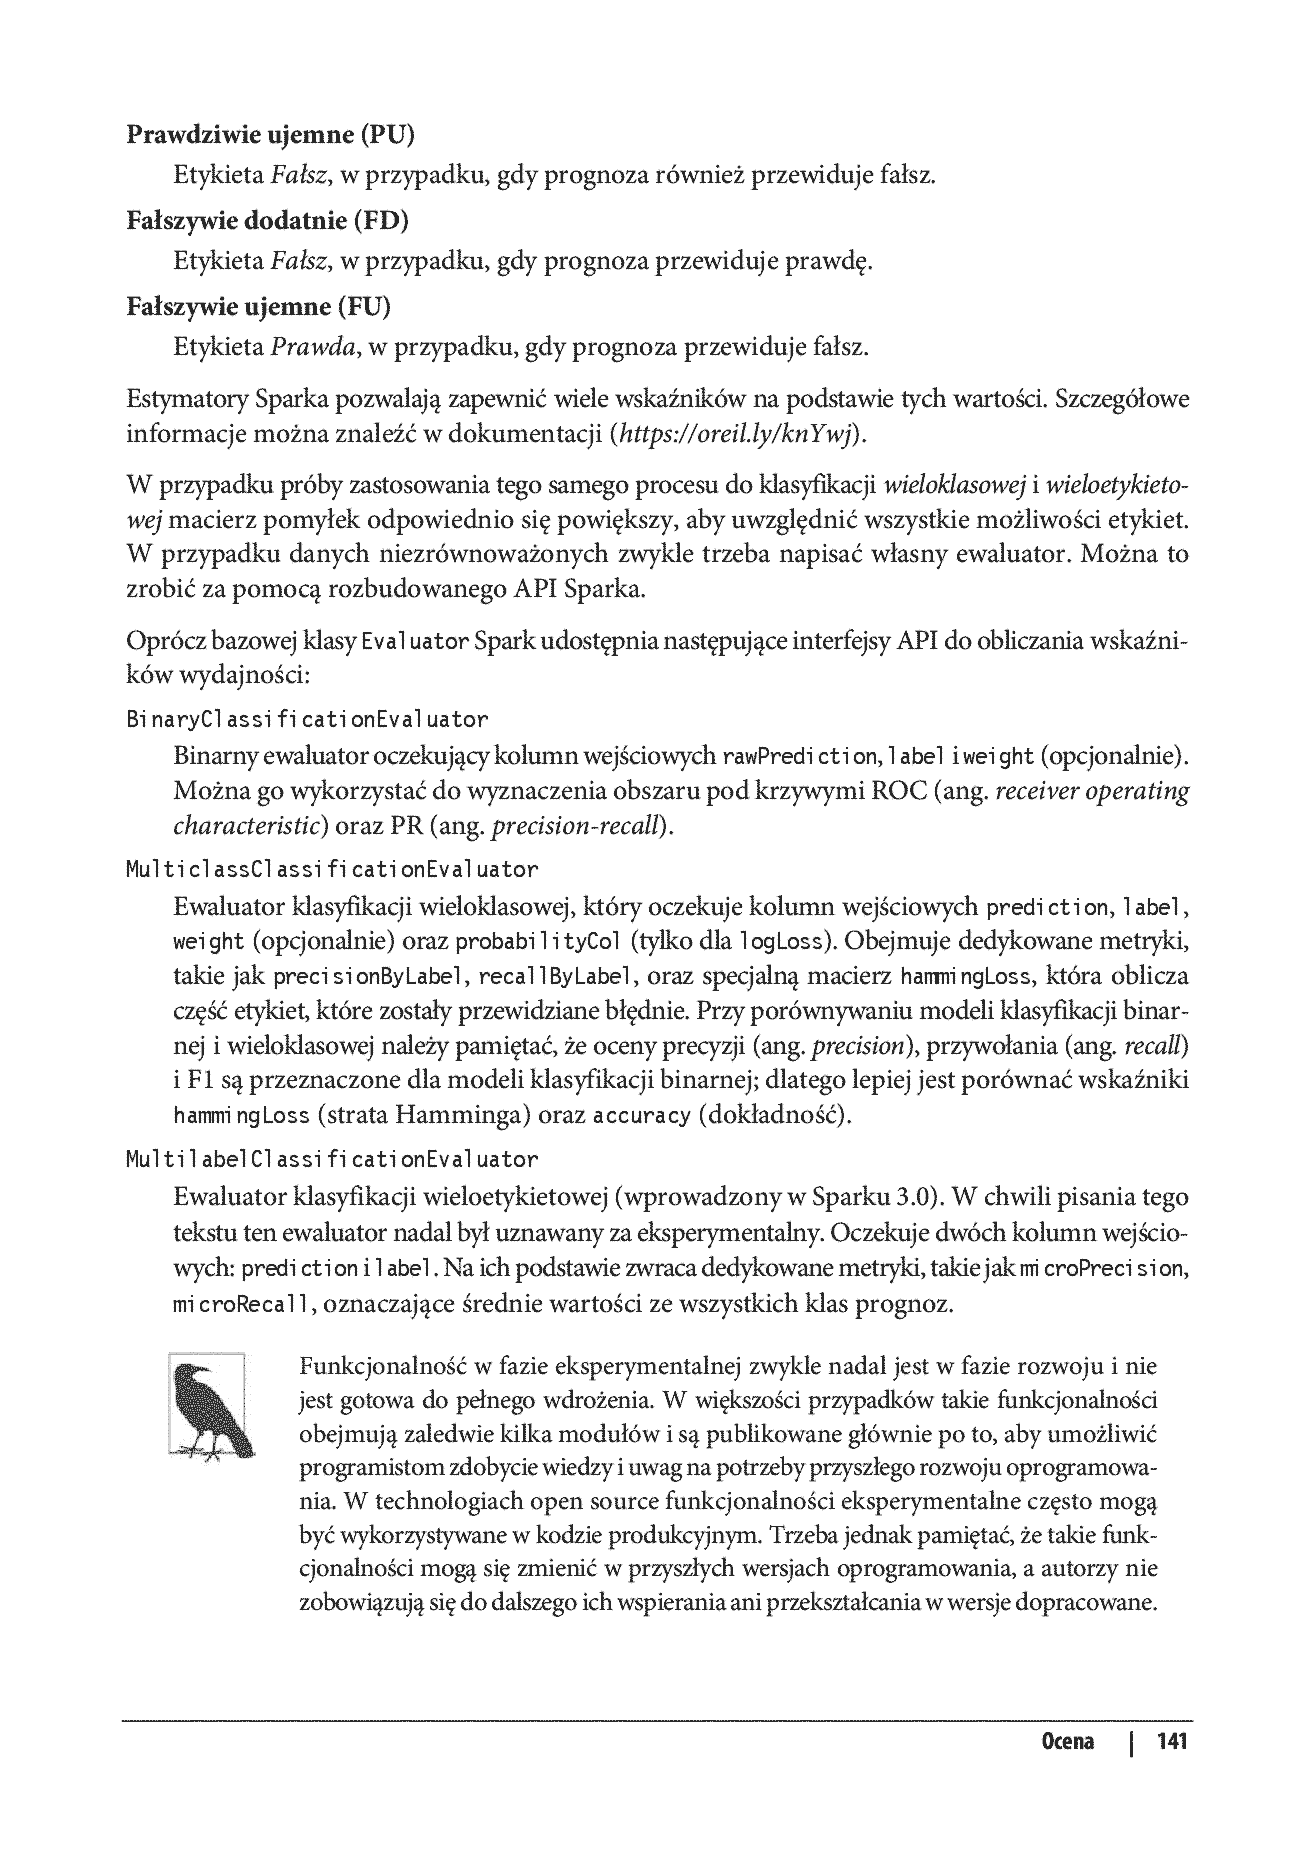
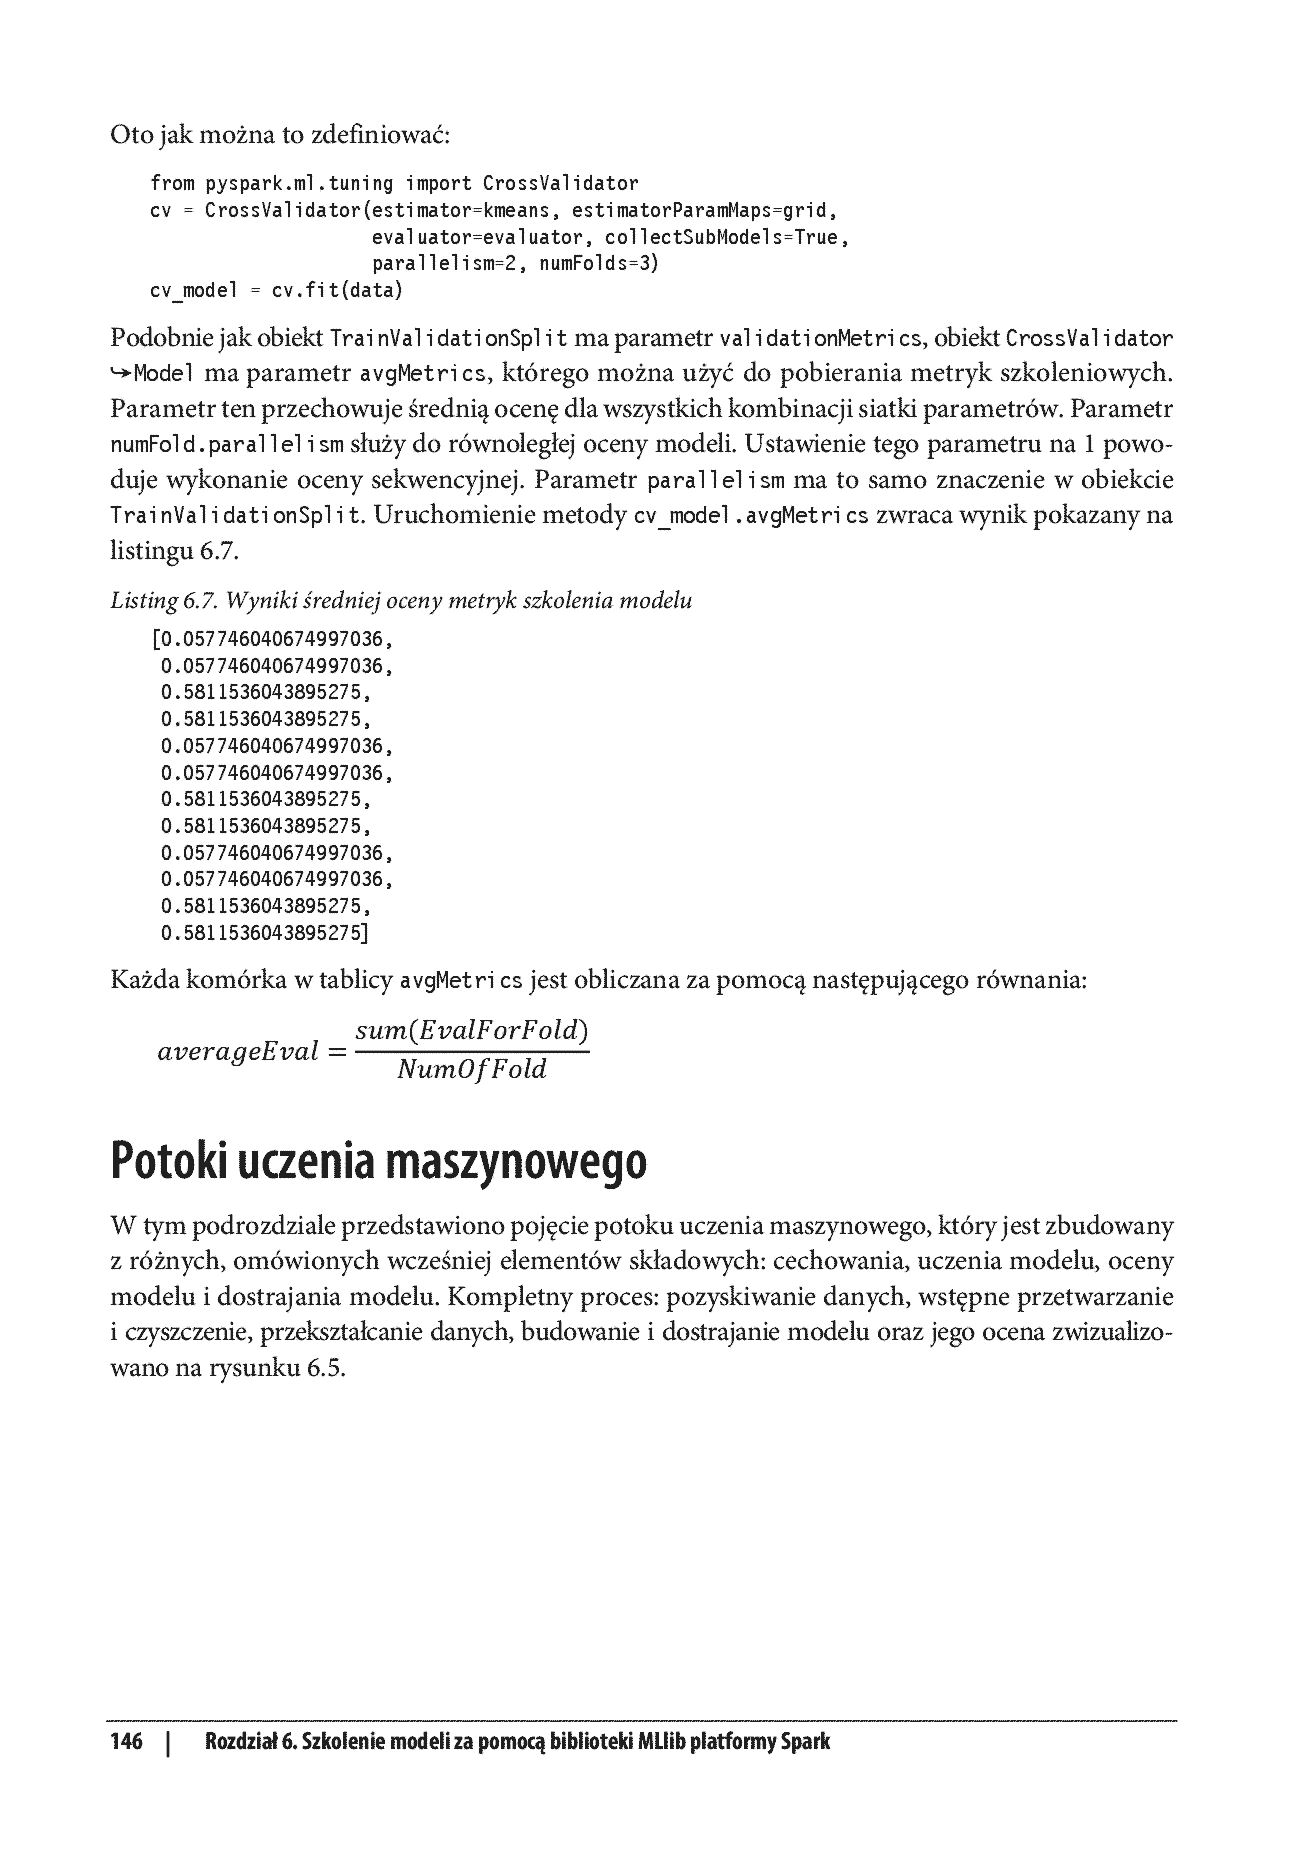
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 1 z 301
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 2 z 302
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 3 z 303
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 4 z 304
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 5 z 305
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 6 z 306
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 7 z 307
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 8 z 308
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 9 z 309
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 10 z 3010
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 11 z 3011
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 12 z 3012
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 13 z 3013
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 14 z 3014
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 15 z 3015
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 16 z 3016
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 17 z 3017
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 18 z 3018
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 19 z 3019
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 20 z 3020
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 21 z 3021
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 22 z 3022
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 23 z 3023
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 24 z 3024
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 25 z 3025
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 26 z 3026
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 27 z 3027
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 28 z 3028
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 29 z 3029
  • Fragment „Spark. Rozproszone uczenie maszynowe na dużą skalę. Jak korzystać z MLlib, TensorFlow i PyTorch” — strona 30 z 3030

Opis

Jeśli chcesz dostosować swoją pracę do większych zbiorów danych i bardziej złożonych kodów, potrzebna Ci jest znajomość technik rozproszonego uczenia maszynowego. W tym celu warto poznać frameworki Apache Spark, PyTorch i TensorFlow, a także bibliotekę MLlib. Biegłość w posługiwaniu się tymi narzędziami przyda Ci się w całym cyklu życia oprogramowania ... nie tylko ułatwi współpracę, ale również tworzenie powtarzalnego kodu.

Dzięki tej książce nauczysz się holistycznego podejścia, które zdecydowanie usprawni współpracę między zespołami. Najpierw zapoznasz się z podstawowymi informacjami o przepływach pracy związanych z uczeniem maszynowym przy użyciu Apache Spark i pakietu PySpark. Nauczysz się też zarządzać cyklem życia eksperymentów dla potrzeb uczenia maszynowego za pomocą biblioteki MLflow. Z kolejnych rozdziałów dowiesz się, jak od strony technicznej wygląda korzystanie z platformy uczenia maszynowego. W książce znajdziesz również opis wzorców wdrażania, wnioskowania i monitorowania modeli w środowisku produkcyjnym.

Najciekawsze zagadnienia:

  • cykl życia uczenia maszynowego i MLflow
  • inżynieria cech i przetwarzanie wstępne za pomocą Sparka
  • szkolenie modelu i budowa potoku
  • budowa systemu danych z wykorzystaniem uczenia głębokiego
  • praca TensorFlow w trybie rozproszonym
  • skalowanie systemu i tworzenie jego wewnętrznej architektury

Właśnie takiej książki społeczność Sparka wyczekuje od dekady!

Andy Petrella, autor książki Fundamentals of Data Observability

Linki do księgarni są linkami partnerskimi Grupy Helion i Księgarni PWN (przez sieć Adtraction). Ceny i dostępność pochodzą z oferty wydawcy i mogą się zmienić.