Fragment książki — 30 stron
Kliknij stronę, żeby powiększyć. Całość możesz przeczytać online albo pobrać jako PDF. Fragment udostępniony przez wydawcę.
 1
 2
 3
 4
 5
 6
 7
 8
 9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
Opis
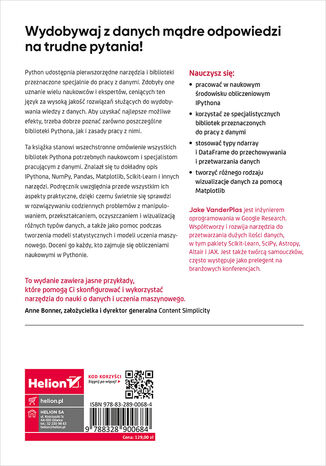
Python udostępnia pierwszorzędne narzędzia i biblioteki przeznaczone specjalnie do pracy z danymi. Zdobyły one uznanie wielu naukowców i ekspertów, ceniących ten język za wysoką jakość rozwiązań służących do wydobywania wiedzy z danych. Aby uzyskać najlepsze możliwe efekty, trzeba dobrze poznać zarówno poszczególne biblioteki Pythona, jak i zasady pracy z nimi.
Ta książka stanowi wszechstronne omówienie wszystkich bibliotek Pythona, potrzebnych naukowcom i specjalistom pracującym z danymi. Znalazł się tu dokładny opis IPythona, NumPy, Pandas, Matplotlib, Scikit-Learn i innych narzędzi. Podręcznik uwzględnia przede wszystkim ich aspekty praktyczne, dzięki czemu świetnie się sprawdzi w rozwiązywaniu codziennych problemów z manipulowaniem, przekształcaniem, oczyszczaniem i wizualizacją różnych typów danych, a także jako pomoc podczas tworzenia modeli statystycznych i modeli uczenia maszynowego. Docenią go wszyscy, którzy zajmują się obliczeniami naukowymi w Pythonie.
To wydanie zawiera jasne przykłady, które pomogą Ci skonfigurować i wykorzystać narzędzia do nauki o danych i uczenia maszynowego.
Anne Bonner, założycielka i dyrektor generalna Content Simplicity
Nauczysz się:
- pracować w naukowym środowisku obliczeniowym IPythona
- korzystać ze specjalistycznych bibliotek przeznaczonych do pracy z danymi
- stosować typy ndarray i DataFrame do przechowywania i przetwarzania danych
- tworzyć różnego rodzaju wizualizacje danych za pomocą Matplotlib
- implementować najważniejsze algorytmy uczenia maszynowego z pakietu Scikit-Learn
Wydobywaj z danych mądre odpowiedzi na trudne pytania!