Fragment książki — 30 stron
Kliknij stronę, żeby powiększyć. Całość możesz przeczytać online albo pobrać jako PDF. Fragment udostępniony przez wydawcę.
 1
 2
 3
 4
 5
 6
 7
 8
 9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
Opis
Data science jest interdyscyplinarną dziedziną naukową łączącą osiągnięcia uczenia maszynowego, statystyki i eksploracji danych. Umożliwia wydobywanie nowej wiedzy z istniejących danych poprzez stosowanie odpowiednich algorytmów i analizy statystycznej. Stworzono dotąd wiele algorytmów tej kategorii i wciąż powstają nowe. Stanowią one podstawę konstruowania modeli umożliwiających wyodrębnianie określonych informacji z danych odzwierciedlających zjawiska zachodzące w świecie rzeczywistym, pozwalają też na formułowanie prognoz ich przebiegu w przyszłości. Algorytmy data science są postrzegane jako ogromna szansa na zdobycie przewagi konkurencyjnej, a ich znaczenie stale rośnie.
Ta książka jest zwięzłym przewodnikiem po algorytmach uczenia maszynowego. Jej cel jest prosty: w ciągu siedmiu dni masz opanować solidne podstawy siedmiu najważniejszych dla uczenia maszynowego algorytmów. Opisom poszczególnych algorytmów towarzyszą przykłady ich implementacji w języku Python, a praktyczne ćwiczenia, które znajdziesz na końcu każdego rozdziału, ułatwią Ci lepsze zrozumienie omawianych zagadnień. Co więcej, dzięki książce nauczysz się właściwie identyfikować problemy z zakresu data science. W konsekwencji dobieranie odpowiednich metod i narzędzi do ich rozwiązywania okaże się dużo łatwiejsze.
W tej książce:
- efektywne implementacje algorytmów uczenia maszynowego w języku Python
- klasyfikacja danych przy użyciu twierdzenia Bayesa, drzew decyzyjnych i lasów losowych
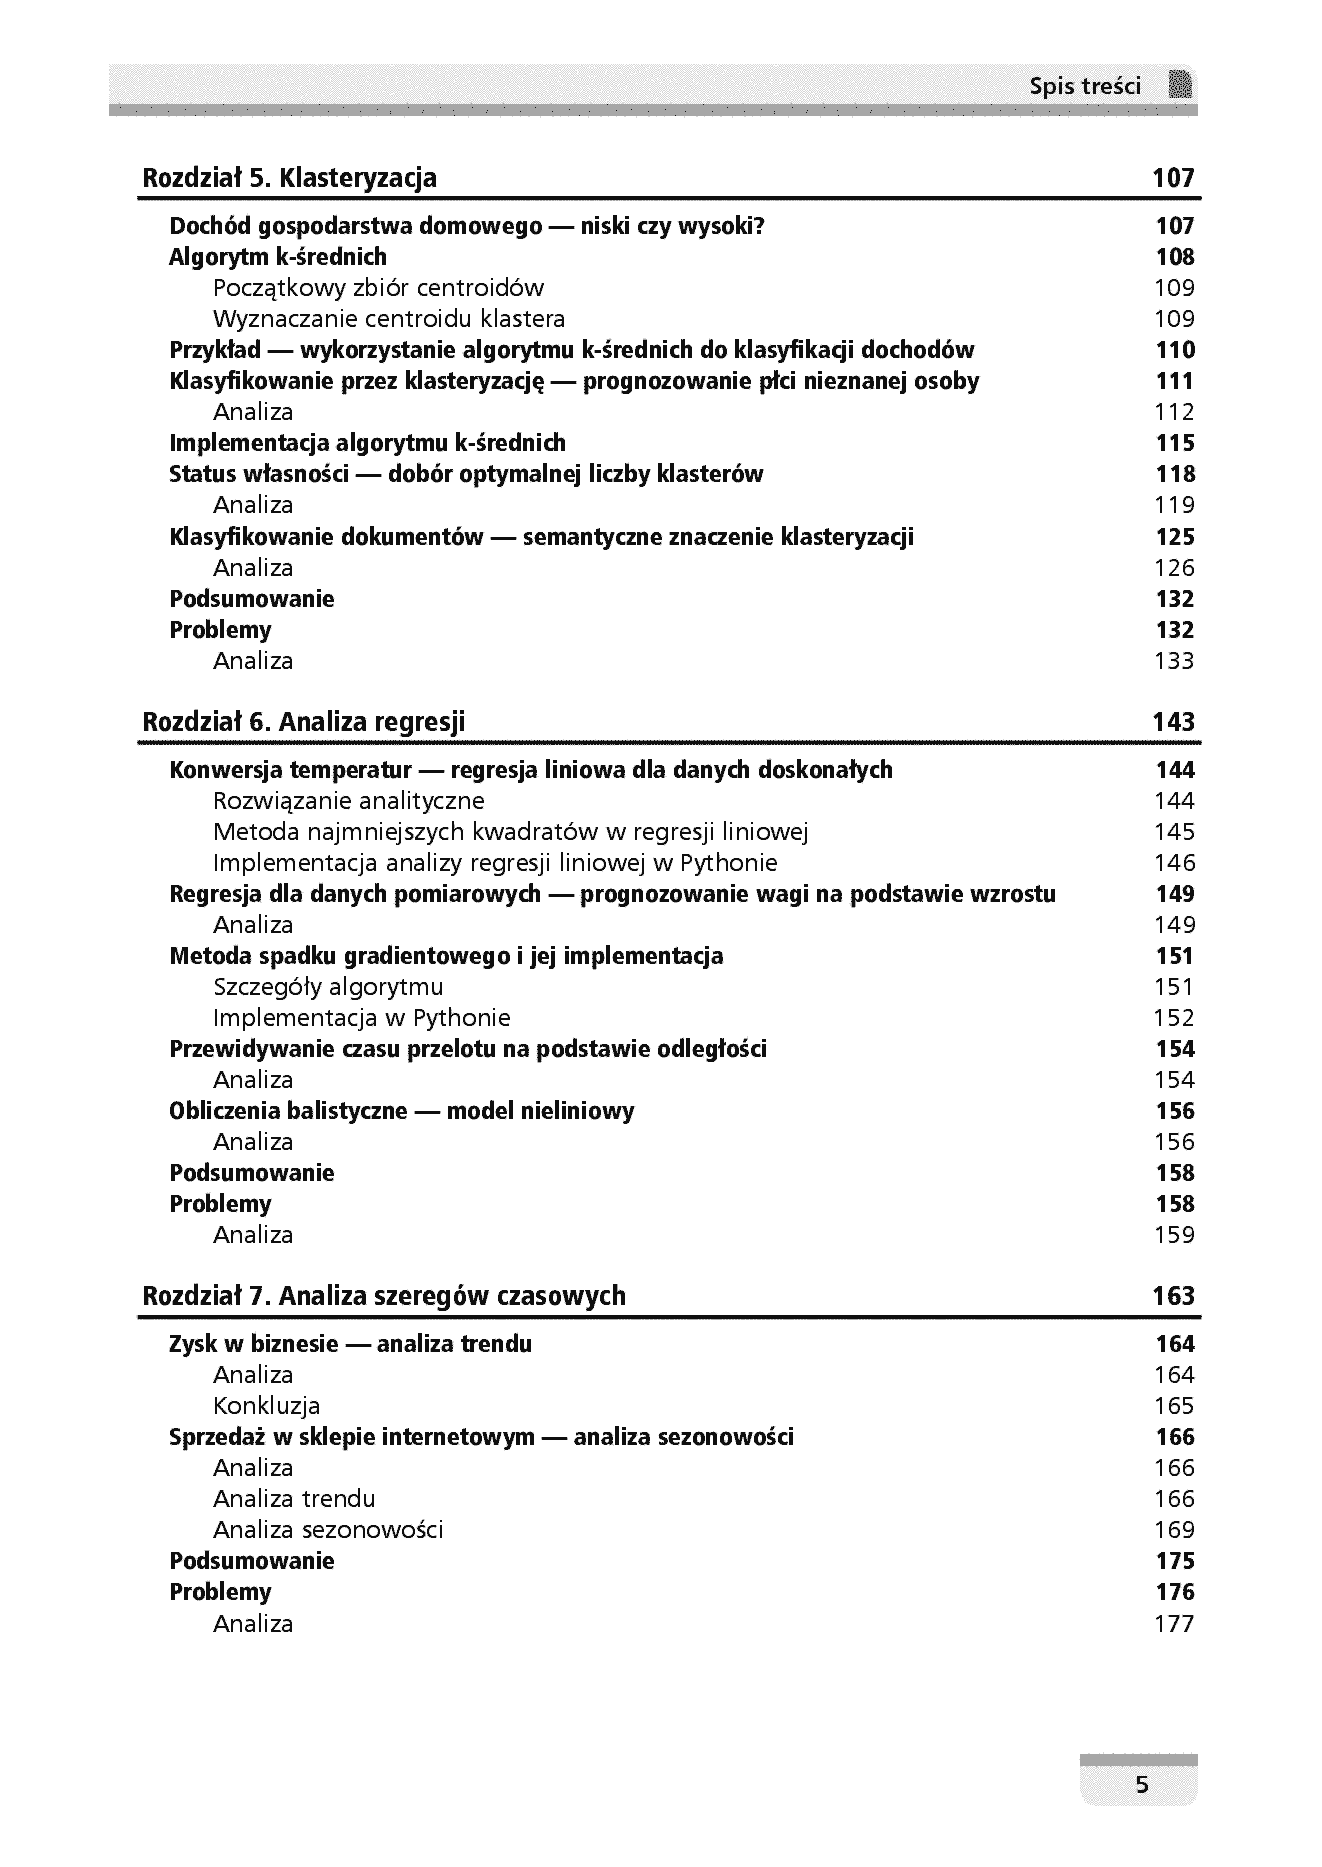
- podział danych na klastery za pomocą algorytmu k-średnich
- stosowanie analizy regresji w parametryzacji modeli przewidywań
- analiza szeregów czasowych pod kątem trendów i sezonowości danych